Học từ dữ liệu thay cho viết mọi quy tắc
Học máy (machine learning) là lĩnh vực của trí tuệ nhân tạo nghiên cứu thuật toán và mô hình để máy tính học từ dữ liệu, rồi đưa ra dự đoán hoặc quyết định.
Với bộ lọc thư, một cách làm là viết sẵn quy tắc như “có cụm từ này thì đánh dấu thư rác”. Cách học máy dùng nhiều ví dụ để thuật toán tìm các đặc điểm liên quan đến thư rác và thư hợp lệ. “Không lập trình cụ thể mọi quy tắc” không có nghĩa không cần chương trình, thuật toán hoặc người thiết kế.
Mô hình là kết quả thu được sau quá trình học, được dùng để xử lí dữ liệu mới. Việc nhận một thư rồi dự đoán nhãn cho nó không tự chứng minh mô hình vừa được huấn luyện lại.
Năm bước ở mức sơ lược
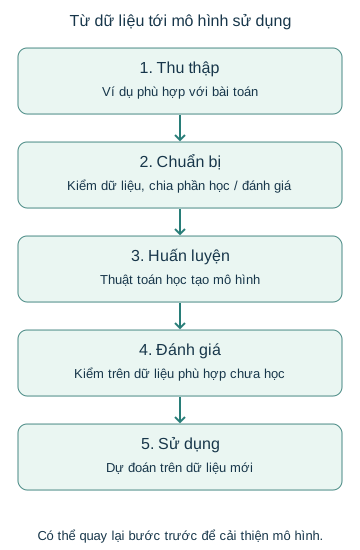
Thu thập dữ liệu đúng bài toán; chuẩn bị dữ liệu; chọn thuật toán và huấn luyện; đánh giá; sử dụng mô hình. Khi dữ liệu hoặc kết quả chưa phù hợp, có thể quay lại bước trước.
Chuẩn bị gồm kiểm lỗi, xử lí giá trị thiếu có căn cứ và đưa dữ liệu về dạng phù hợp. Ô trống có thể là chưa ghi nhận, nên không tự thay mọi ô trống bằng số 0. Chất lượng dữ liệu và cách gán nhãn ảnh hưởng tới mô hình.
Dữ liệu học khác với dữ liệu đánh giá
Dữ liệu huấn luyện dùng để xây dựng mô hình. Dữ liệu kiểm thử giúp xem khả năng xử lí những trường hợp chưa dùng để học. Không đặt bản sao cùng một mẫu vào cả hai phần rồi coi là đánh giá độc lập.
Nếu dùng một phần dữ liệu nhiều lần để chọn hoặc điều chỉnh mô hình, đó là phần phục vụ xác thực/điều chỉnh. Cần giữ phần kiểm tra cuối độc lập. Chia tập hợp lí giúp đánh giá, nhưng không tự bảo đảm mô hình đúng trong mọi hoàn cảnh.
Ví dụ giả định: mô hình phân loại đúng 36 trong 40 thư đánh giá, tỉ lệ đúng trên tập ấy là 36/40 = 90%. Kết quả này không có nghĩa mọi thư mới đều đúng. Cần xem cả thư rác bị bỏ sót và thư hợp lệ bị chặn nhầm.
Bài luyện
Điểm nào thể hiện cách học máy để xây bộ lọc thư?
Đây là cách quy định sẵn toàn bộ luật, chưa thể hiện học từ mẫu.
Đúng. Thuật toán sử dụng dữ liệu để xây mô hình.
Lưu dữ liệu chưa phải huấn luyện mô hình.
Gán ngẫu nhiên không tạo bộ lọc đáng tin cậy.
Lời giải
Học máy tìm mối liên hệ từ dữ liệu bằng thuật toán học, thay cho việc viết sẵn mọi luật phân loại. Trong tình huống này, các thư mẫu được dùng để huấn luyện mô hình; việc lưu thư đơn thuần chưa đủ.
Bài luyện
Một mô hình đã huấn luyện dự đoán nhãn cho thư mới. Kết luận nào phù hợp?
Dự đoán và cập nhật mô hình là hai việc khác nhau.
Việc sử dụng mô hình vẫn do chương trình thực hiện.
Đúng. Dự đoán không tự chứng minh có bước học lại.
Mô hình vẫn có thể sai trên dữ liệu mới.
Lời giải
Huấn luyện tạo hoặc cập nhật mô hình; sử dụng mô hình áp dụng kết quả đã học cho đầu vào mới. Một hệ thống có thể chỉ dự đoán ở thời điểm nhận thư và cập nhật theo quy trình riêng.
Bài luyện
Cách đánh giá nào dễ làm kết quả lạc quan quá mức?
Giữ độc lập hỗ trợ đánh giá dữ liệu mới.
Xem lỗi giúp hiểu giới hạn mô hình.
Mẫu mới phù hợp là điều cần xét.
Đúng. Mẫu trùng làm mất tính mới của phép đánh giá.
Lời giải
Mục đích kiểm thử là xem khả năng xử lí trường hợp chưa dùng để học. Bản sao của mẫu huấn luyện khiến một phần bài kiểm không còn mới, nên tỉ lệ đúng có thể không phản ánh khả năng áp dụng thực tế.
Bài luyện
Mô hình đúng 36 trong 40 thư đánh giá. Cách diễn giải nào đúng?
Đúng. Tỉ lệ có phạm vi và chưa mô tả mọi loại lỗi.
Tỉ lệ chung chưa cho biết bao nhiêu thư rác bị bỏ sót.
Vẫn có 4 dự đoán sai trong tập đã cho.
Dữ liệu mới có thể khác tập đã đánh giá.
Lời giải
36/40 = 0,9 = 90%. Đây là kết quả trên 40 thư của đề, không phải bảo đảm cho mọi dữ liệu khác. Cần xem 4 lỗi thuộc những loại nào để đánh giá bộ lọc theo mục đích sử dụng.
Đang học